当一次仿真或实验代价很高时,下一次评估应该放在哪里?NextEval 将这个问题同时用于优化求解和 Agent 评测:Agent 能否利用已经获得的观测,决定接下来该做什么,并在有限预算内取得更好的结果?
这是我与合作者共同开展的工作。我是项目负责人和通讯作者之一,论文 NextEval: An Agent-Based Solver and Benchmark for Derivative-Free Optimization 已于 2026 年 10 月 27 日在 arXiv 公开。
NextEval Bench:评测连续决策的能力 链接到标题
NextEval Bench 通过无导数优化(DFO)任务评测 Agent。Agent 面对一个黑盒目标函数,在固定的函数评估预算内获得观测、选择动作,并根据反馈继续搜索。最终表现取决于一连串决策及其相互影响。
比较不同 Agent 配置时,我们固定任务、数值工具、函数评估预算和可用信息。配置包含模型、执行框架(harness)、提示词和推理设置。Agent 可以使用观测与工具反馈,但不能访问问题名称、函数公式或已知最优解。
同一组问题,四类任务设置 链接到标题
截至 11 月 9 日,官网公开评测 使用 S2MPJ 中 92 个维度不超过 5 的无约束问题,在同一组基础问题上构造四类设置:
| 任务 | 设置与决策要求 |
|---|---|
| 起点扰动 | 将初始点移离标准起点,根据新起点附近的观测调整搜索。 |
| 观测噪声 | 返回的函数值带有噪声,在改进幅度不确定时继续作出有效决策。 |
| 坐标旋转 | 使用旋转后的坐标,在有用方向未必沿坐标轴时进行搜索。 |
| 随机 NaN | 部分函数评估无法返回可用数值,需要在查询失败后继续搜索。 |
噪声、旋转和随机 NaN 任务也使用扰动后的起点。每类设置使用固定随机种子重复三次,因此每类有 276 个“问题 × 重复”案例,四类合计 1,104 个案例,来自同一组 92 个基础问题。
每次运行最多进行 50 × 维度 次函数评估:二维问题允许 100 次,五维问题允许 250 次。实际调用目标函数才消耗这个预算,分析已有观测不消耗函数评估次数。工具调用数、LLM 调用数、token 和运行时间分别记录。因此,Agent 可以投入更多推理,但不会因此获得更多目标函数查询额度。
比较的是怎样的 Agent 配置? 链接到标题
公开结果将模型、执行框架和推理强度一起标注。例如,同一个模型通过 Codex 或 Claude Code 运行,属于不同配置:上下文管理、工具执行和会话恢复都可能影响结果。
在规定的协议下,相同问题和随机种子为配置比较提供共同条件。失败和超时运行仍保留在评测分母中。因此,结果既体现改进目标函数的能力,也体现能否可靠地完成整个优化会话。
COBYQA 配对分数如何计算? 链接到标题
当前网站在每类任务中,将每个 Agent 单独与 COBYQA 比较。对同一个问题和同一次重复,两者使用共同的初始函数值;评分参考值取初始值、Agent 最佳值与 COBYQA 最佳值三者中的最小值。这个参考值用于评分,不提供给 Agent。带噪声的运行使用无噪声目标值评分。
评测检查从 1e-1 到 1e-10 的十档相对下降精度,记录首次达到各目标所需的函数评估次数;未达到目标时,所需次数记为无穷大。OptiProfiler 将这些次数汇总为性能剖面。在每档精度下,用两条曲线中较大的面积归一化各自面积,再对十档精度取平均,得到 s_agent 和 s_COBYQA。
网站显示的分数为:
score = (1 + s_agent - s_COBYQA) / 2
因此,0.500 表示与 COBYQA 持平,高于它表示相对于这个参考求解器获得了更好的剖面面积结果。举例来说,Agent 和 COBYQA 的归一化面积分别为 1.0、0.8 时,分数为 0.600;这并不表示 Agent 在 60% 的问题上获胜。四类任务的总均分是四个任务分数的算术平均。
只要这两者的运行记录不变,加入其他 Agent 不会改变已有配对分数。不过,不同 Agent 与 COBYQA 配对时,评分目标可能不同;两个 Agent 的分数相近,不能直接解释为它们相互比较时打平。完整的剖面积分与评分约定见评测方法。
除了总分,还能看什么? 链接到标题
- 任务矩阵:横向查看四类设置,按模型家族或执行框架筛选,观察表现在哪些任务上发生变化。空白单元格表示没有可用结果。
- 性能与数据剖面:性能剖面展示在相对于配对中较快一方的评估次数倍率内,能达到目标的案例比例;数据剖面则按“维度 + 1”缩放评估次数。曲线越高,表示在对应额度内达到目标的案例越多。
- Agent 与任务详情页:查看某个 Agent 与其 COBYQA 参考的曲线,再进入逐个问题的优化历史。对数比图可以区分谁用了更少的评估;只有一方达到目标的案例会单独标记。
- Pareto 视图:结合报告的用量与 API 等价费用看性能。部分用量来自估计,应结合标注阅读,不能将其当作实际账单。
我建议先看各任务的差异,再挑几个问题检查搜索历史。总分的小幅差异可能来自重复运行波动,网站目前也建议谨慎对待约 0.05 以下的差距。此外,当前问题集是公开的低维问题,起点扰动和旋转并不能保证模型无法识别问题。理解这些条件,才能更准确地判断 Bench 测到了什么。
从可视化中能看到什么? 链接到标题
以下图表根据 11 月 6 日的公开快照重绘,于 11 月 9 日读取。它们采用官网展示的配置、COBYQA 配对分数及每类任务三次重复的设置。配图数据保留了来源链接、哈希和以下分析使用的数值。这些分析描述的是该快照中的现象。
1. 最高分只是一个预算选择 链接到标题
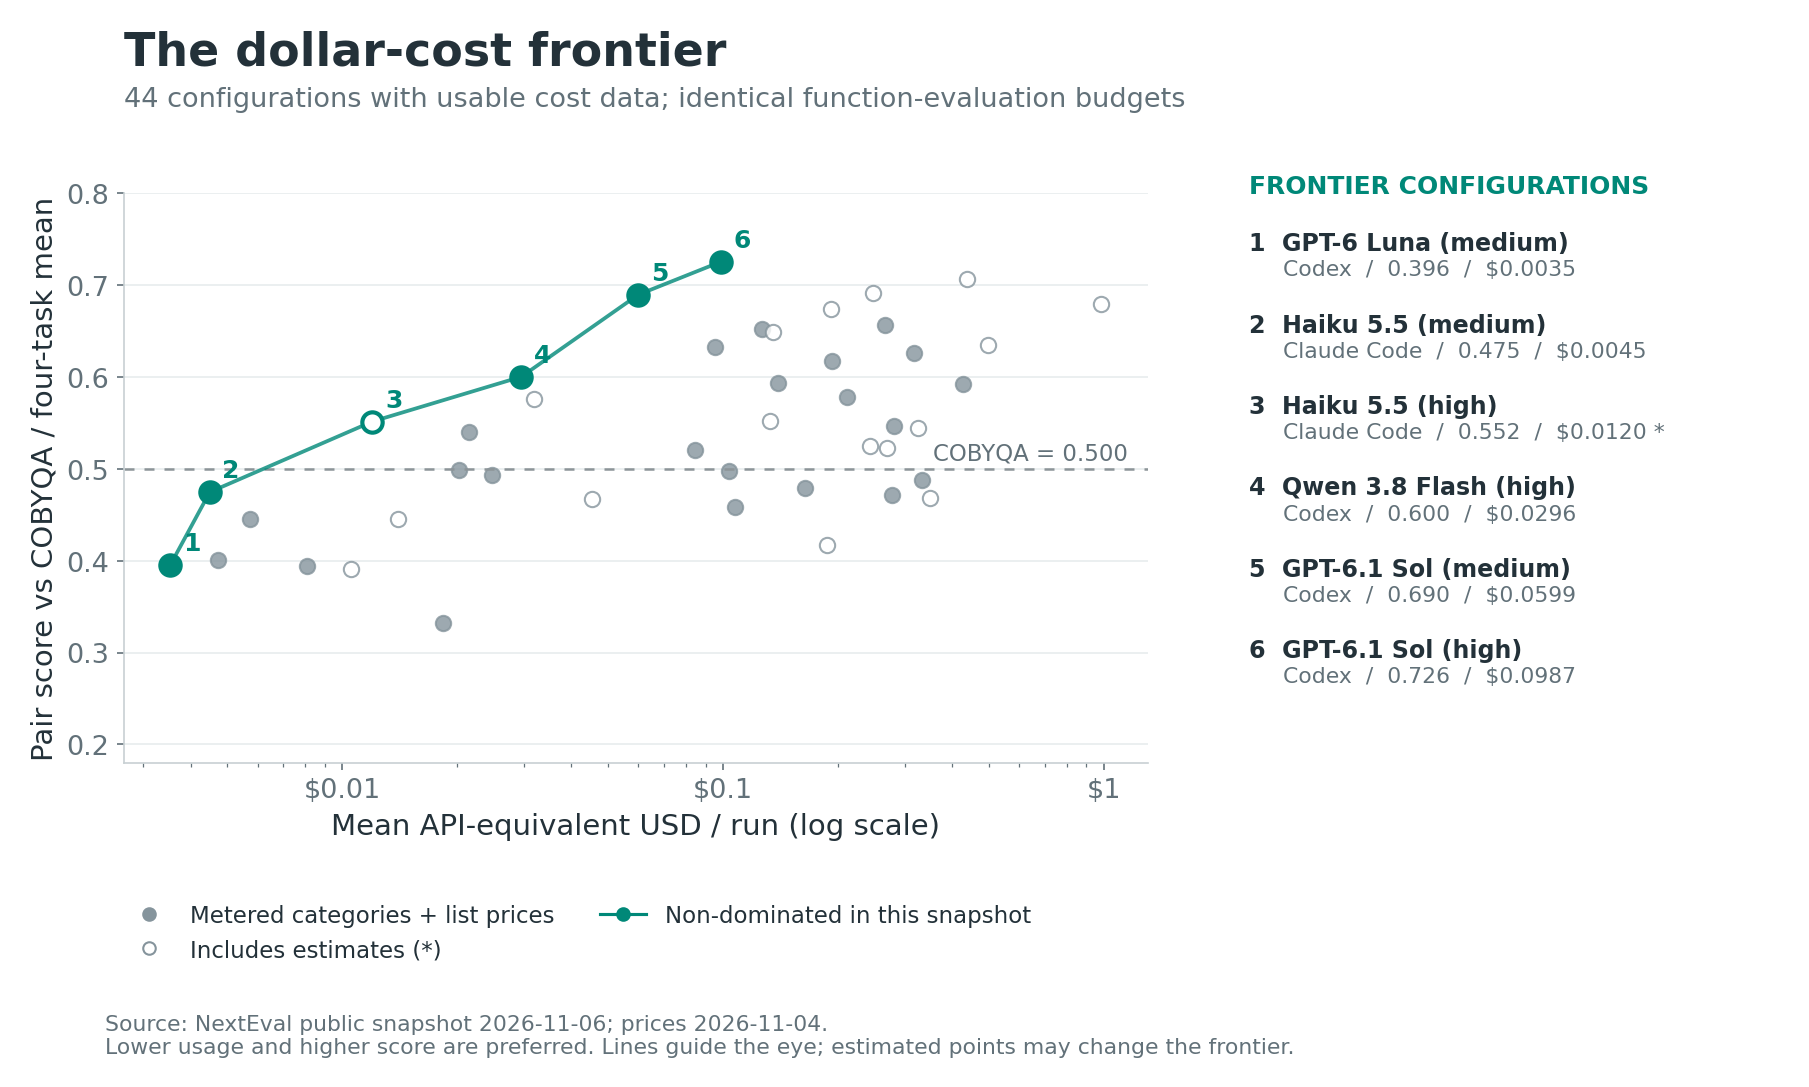
纵轴为四类任务平均配对分数,横轴为每次运行的平均 API 等价美元费用。价格日期为 11 月 4 日,空心点包含估计用量。交互式成本视图。
以 Codex 中的 GPT-6.1 Sol 为例:medium 的平均分数为 0.690,约 $0.0599/次运行;high 为 0.726,约 $0.0987/次运行。后者费用增加约 65%,对应显示分数增加 0.036。这首先是一个预算选择;仅凭这一小幅分数差异,还不能确认有统计上可靠的收益。
前沿也包含更便宜、分数更低的配置。“非支配”只表示当前展示的配置中,没有另一个同时更便宜且分数更高的选择,并不代表它满足应用所需的质量门槛。图中的 COBYQA 虚线有助于区分这两个问题。45 个展示配置中,44 个有四类任务完整的可用成本数据,其中 17 个点包含估计用量。
2. 美元便宜,不代表 token 用得少 链接到标题
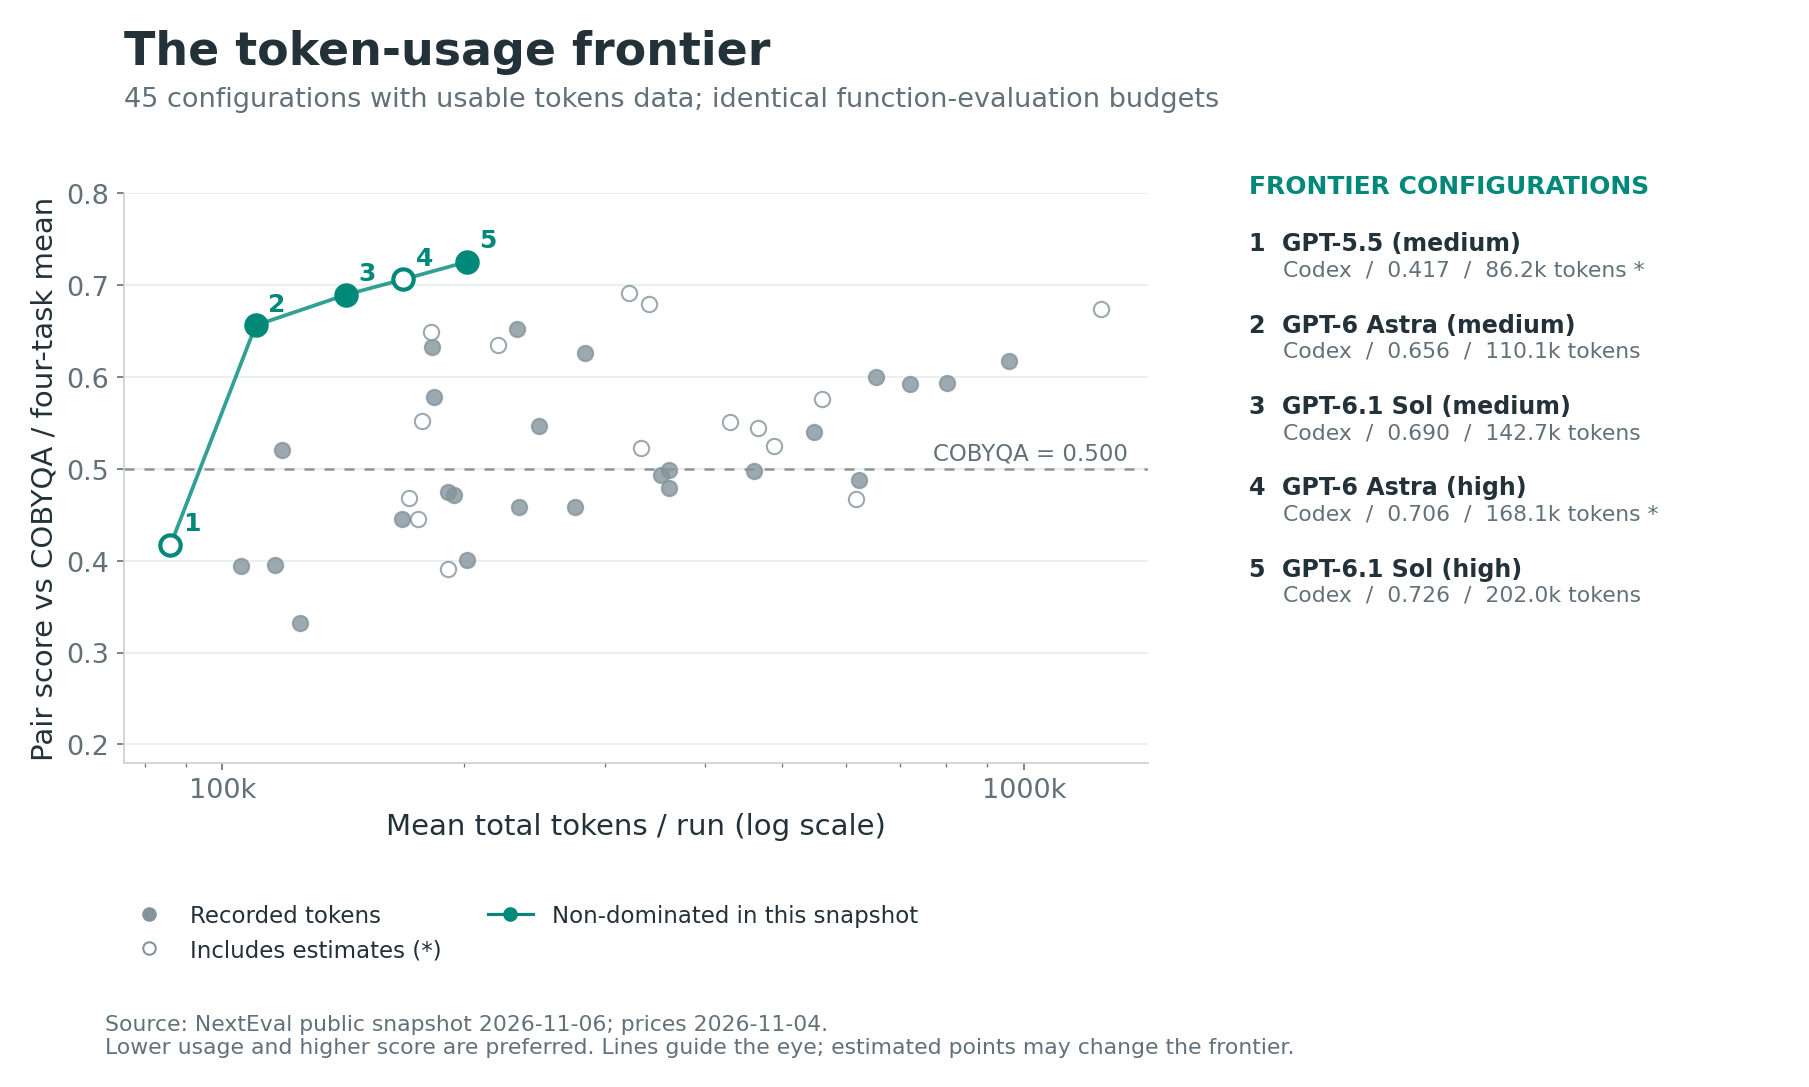
45 个配置都有四类任务的可用 token 数据,其中 17 个点包含估计。交互式 token 视图。
Codex 中的 Qwen 3.8 Flash(high)位于美元成本前沿:约 $0.0296/次运行,平均分数 0.600。但它平均每次运行使用约 65.4 万 token。GPT-6.1 Sol(medium)约为 14.3 万 token,平均分数也更高,为 0.690,因此 Qwen 不在 token 前沿上。
两张图回答的是不同问题。美元费用受定价和 token 类别影响,token 总量则反映另一种资源使用情况。对于优化应用,我会将这两者与函数评估预算一起考虑,而不只看按分数排列的榜单。图中的美元费用按公开标价折算,不是实际账单。
3. 坐标旋转暴露了共同的薄弱环节 链接到标题
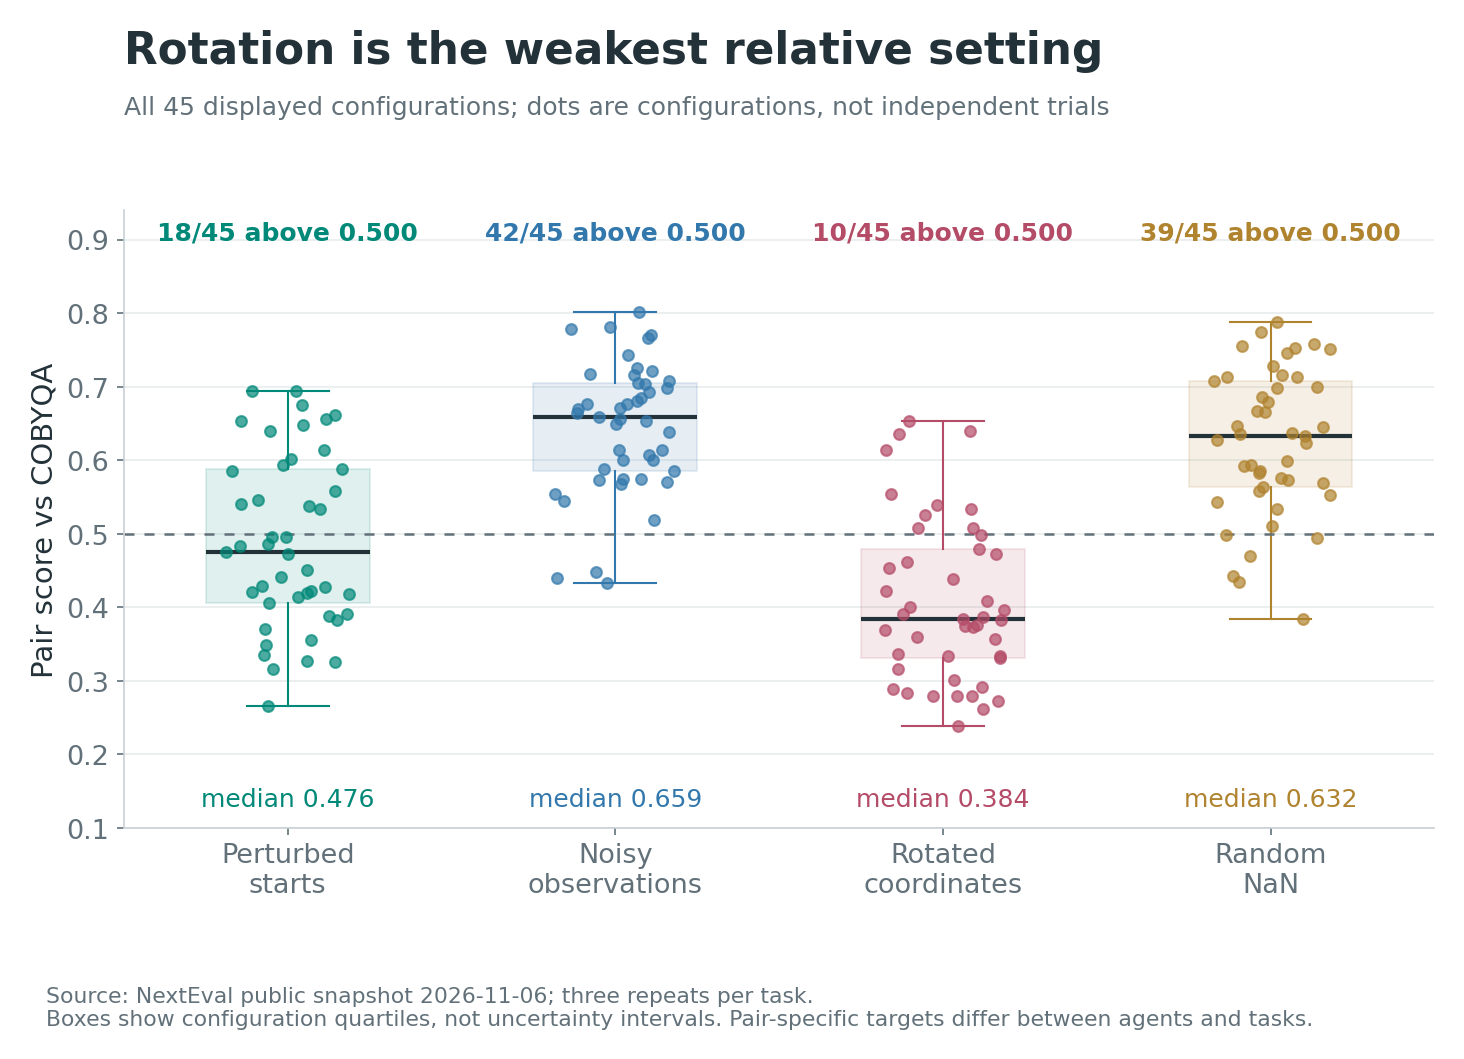
每个点是一个配置,不是一个独立的实验重复。箱体汇总配置分布的四分位数。任务矩阵。
旋转任务中,只有 10/45 个配置高于 0.500;噪声任务中则有 42/45。两者中位数分别为 0.384 和 0.659;起点扰动与随机 NaN 的中位数分别为 0.476 和 0.632。
因此,旋转是当前系统一个值得重点检查的设置:当坐标对齐发生变化时,Agent 相对于 COBYQA 的表现往往更弱。这提示我们进一步查看搜索方向选择和局部模型的行为,但这张图本身不能确定原因。它也不表示噪声让优化变容易了,因为不同任务有各自的 Agent–COBYQA 比较和评分目标。
4. Harness 的影响取决于模型 链接到标题
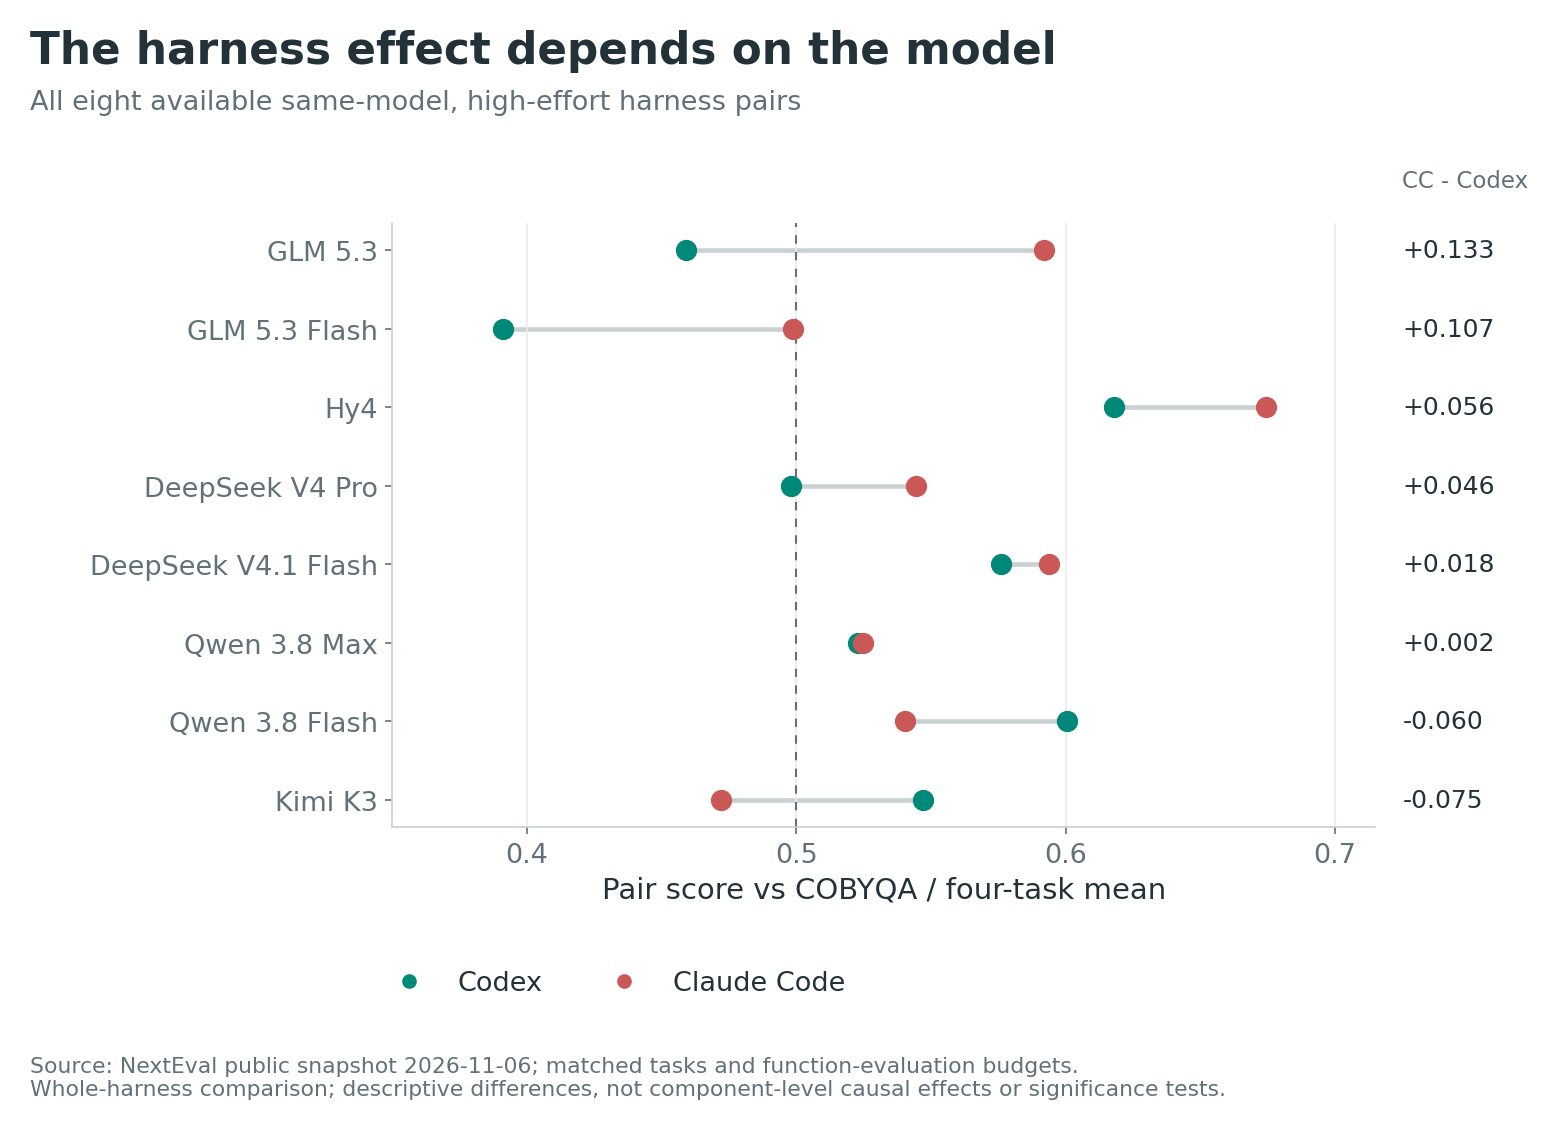
包含所有八组可用的同模型、high 配置;右侧为 Claude Code 减去 Codex 的四任务平均配对分数差。
GLM 5.3 从 Codex 中的 0.459 变为 Claude Code 中的 0.592;Kimi K3 的方向则相反,从 0.547 变为 0.472。Qwen 3.8 Max 的差异很小,两者分别为 0.523 和 0.525。
这对实际使用的启示是:应当评测模型与 harness 的组合。不同模型上的变化方向并不一致。这里比较的是包含工具处理、上下文管理等因素的完整系统,不能将差异单独归因于某个组件,也不能认为每一个分数差都已得到显著性验证。
5. 总分很强,仍然会在具体案例上失手 链接到标题
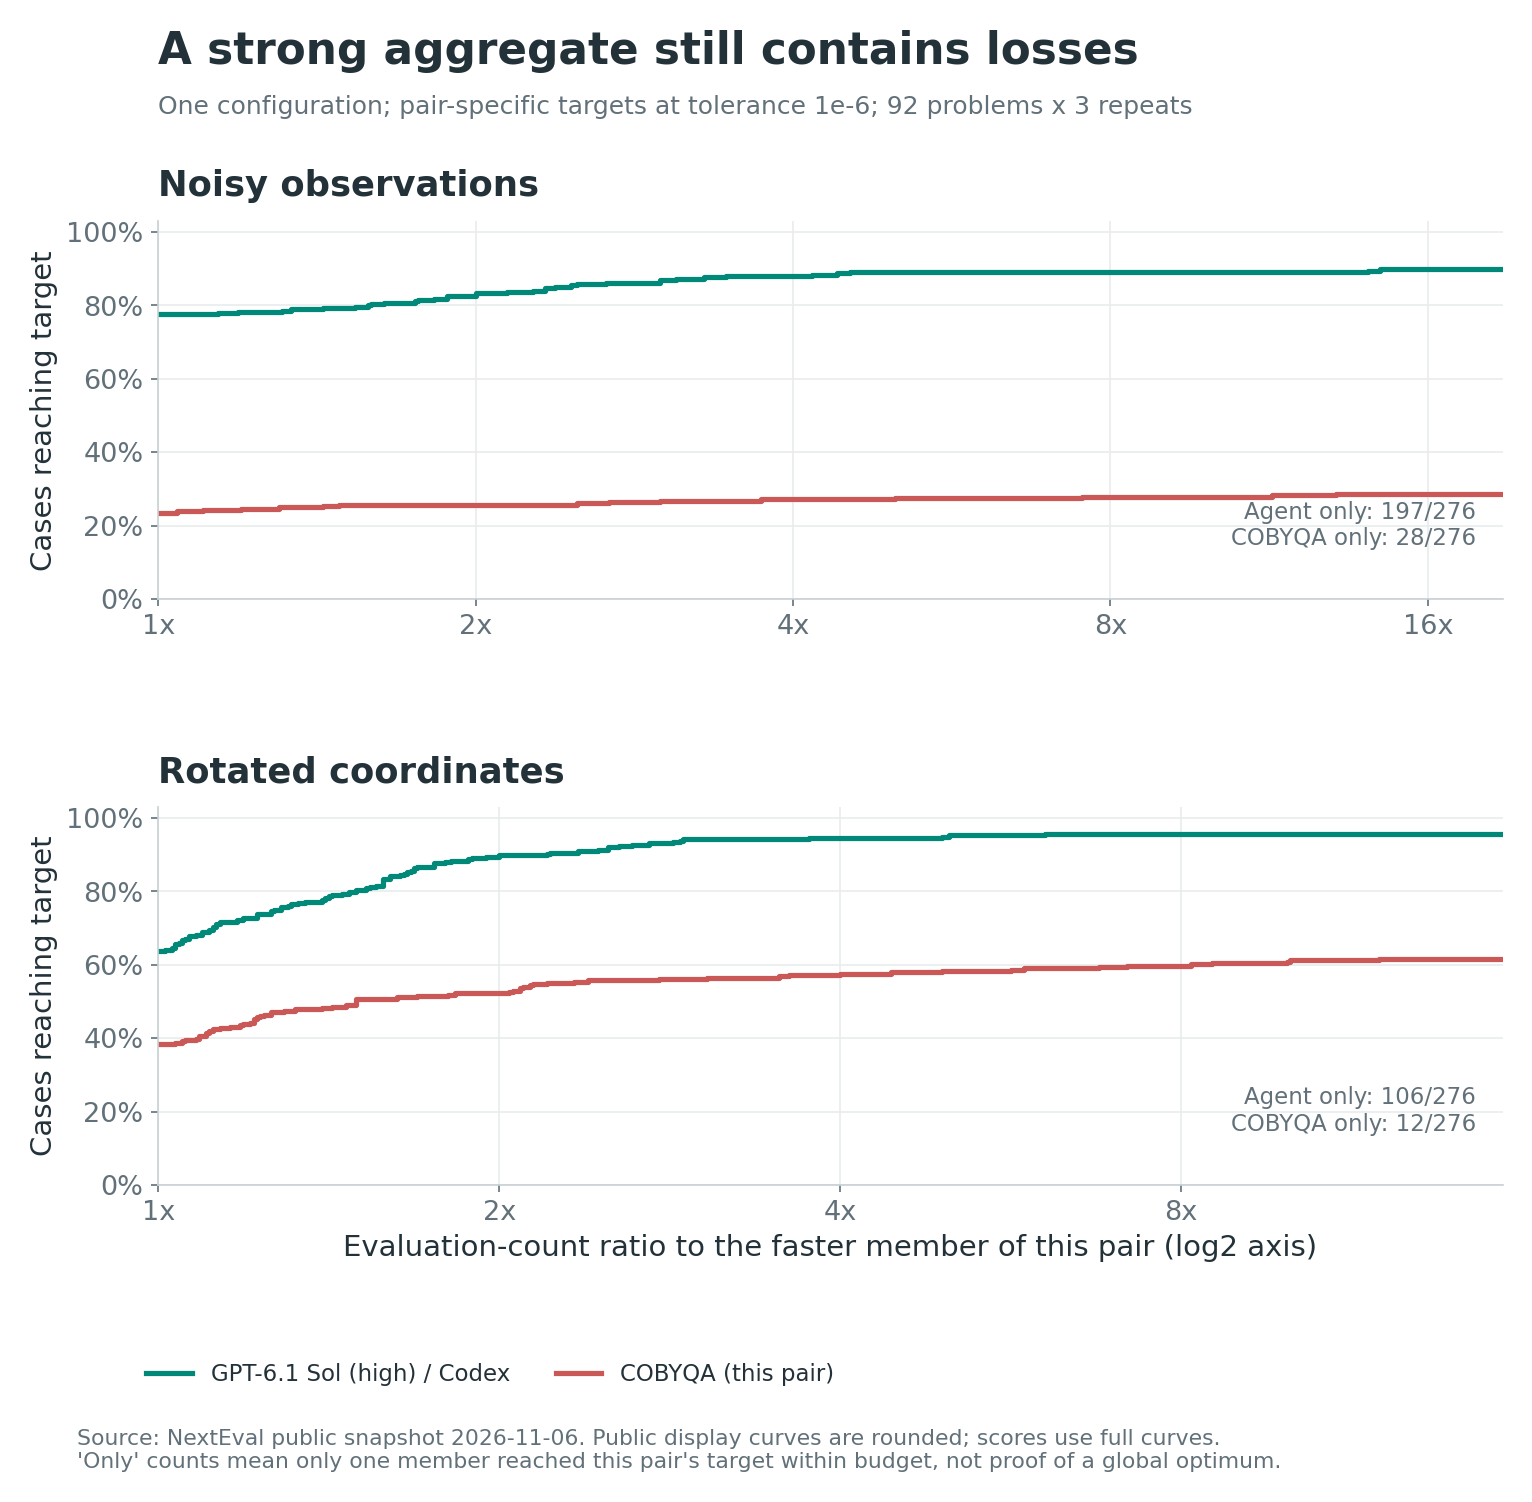
选取该快照中四任务均分最高的配置作为案例。每个面板有 276 个案例,精度为 1e-6,目标按各自配对定义。查看这个 Agent。
噪声任务中,有 197 个案例只有 Agent 达到目标,同时也有 28 个案例只有 COBYQA 达到目标。旋转任务中的对应数字是 106 和 12。因此,即便均分最高,也仍存在经典求解器成功而 Agent 没有达标的案例。
性能剖面帮助区分了两个问题:多快达到目标,以及预算内能否达到目标。接下来的分析可以聚焦于只有 COBYQA 达标的历史,检查是否出现过早停止、无效的方法切换或不合适的搜索尺度。曲线帮助定位这些问题;具体行为解释仍需要搜索记录来支持。
NextEval Solver:Agent 决策,数值工具执行 链接到标题
NextEval Solver 将 LLM Agent 与数值环境结合。Agent 选择工具、调整参数、分配每次调用的评估额度;数值方法负责计算候选点并评估目标函数。
工具支持检查搜索进展、拟合局部模型,以及执行信赖域搜索、轮询搜索、线搜索等操作。环境统一保存函数评估历史,并分别保留各数值方法的状态。因此,Agent 可以根据反馈切换方法,之后再继续之前的搜索;恢复时,环境会检查并按需更新保存的状态。
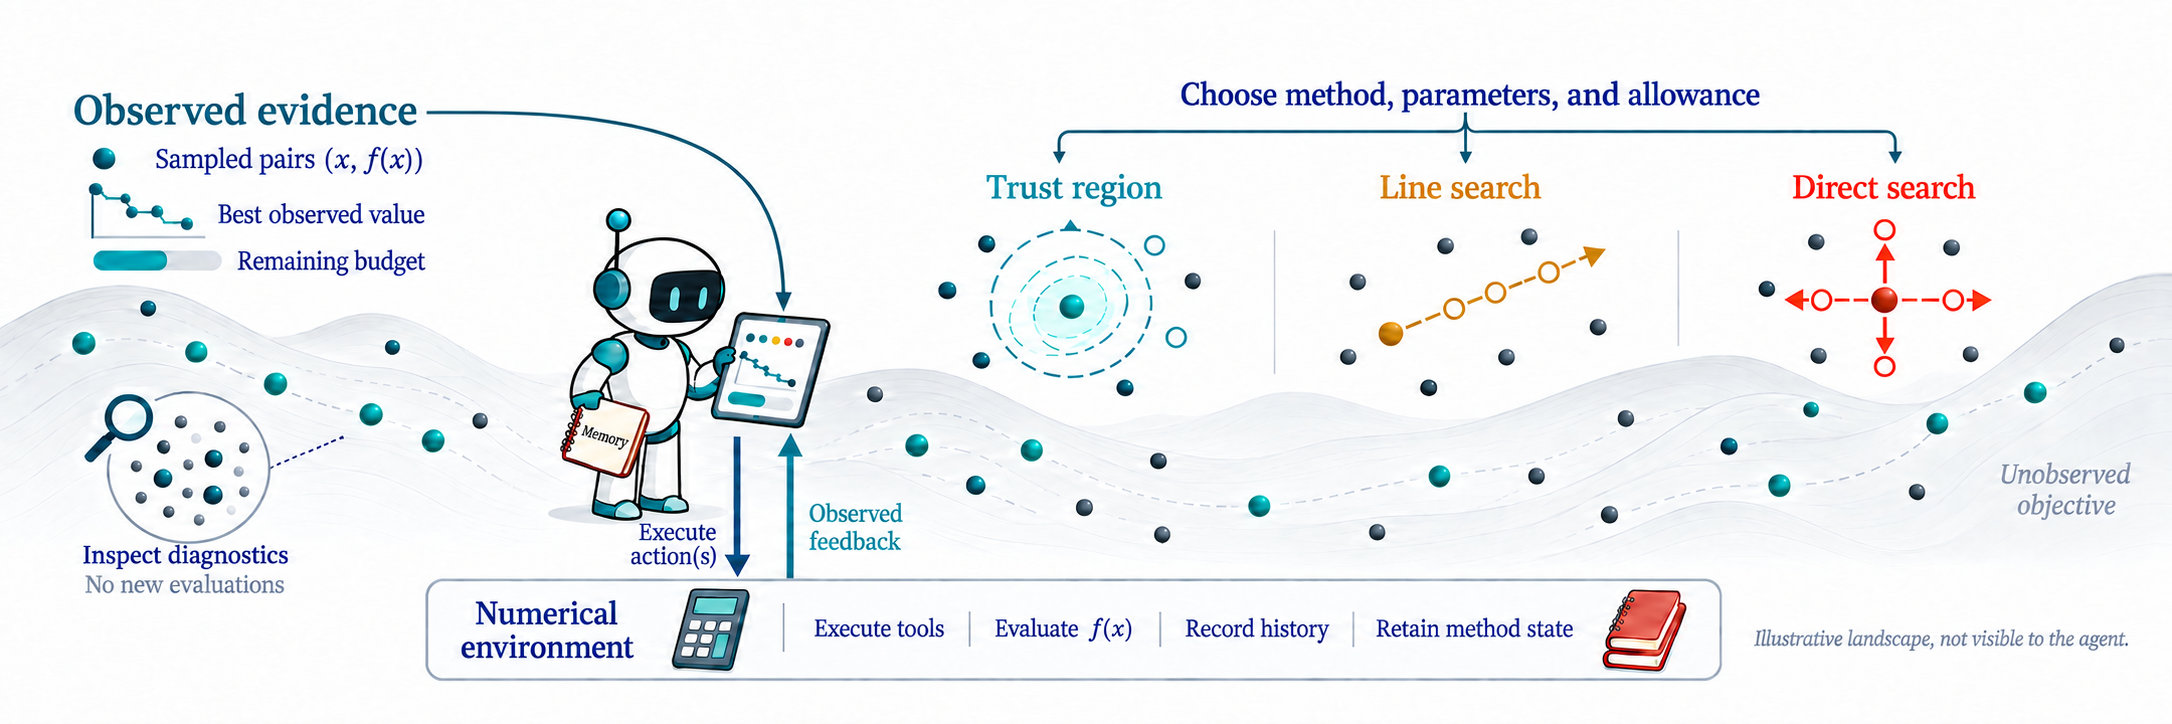
配图来自论文图 1。图中的目标函数地形仅用于示意,Agent 在求解时无法看到。
论文结果与官网更新 链接到标题
论文在所测试的低维问题上,展示了 NextEval 相对于所比较的经典求解器的函数评估效率优势,并通过控制实验考察模型、推理设置和执行框架的影响。这里评价的是 Agent 与数值工具构成的完整系统;这些实验尚不能单独归因于 LLM,也没有确立在未见问题族上的泛化表现。
官网会继续更新。当前四类任务、三次重复的公开评测及其 COBYQA 配对分数,应按网站的方法说明解读,与论文中报告的实验快照分别阅读。
对我而言,NextEval 将两件感兴趣的事连接起来:构建实用的数值优化工具,以及理解 Agent 如何利用反馈作出决策。想尝试求解器,可以从 Solver 使用指南 开始;想了解评测结果和具体搜索过程,可以直接浏览 Bench。